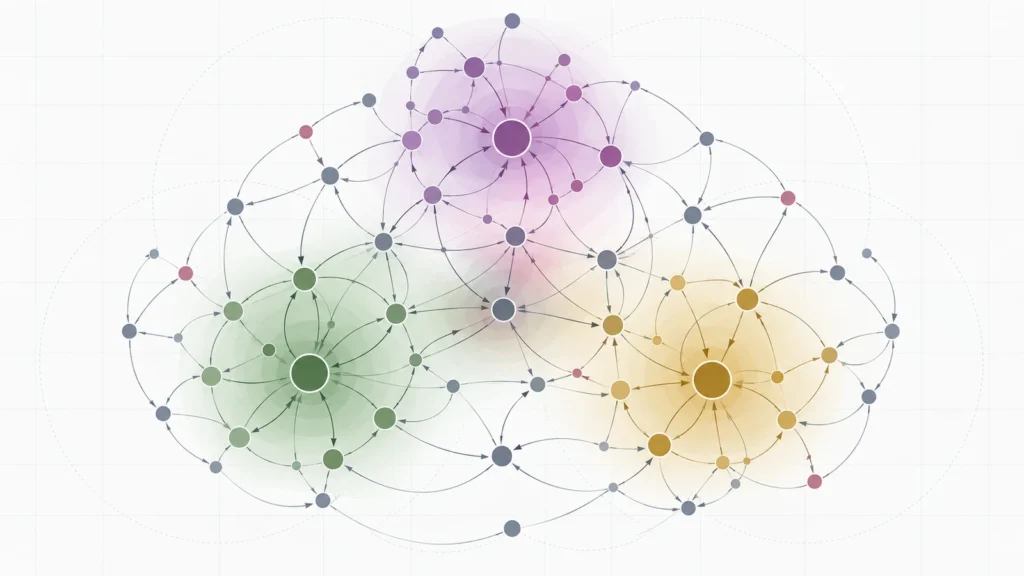
Un'università, un grande quotidiano e un archivio medico possono essere tutti nodi importanti del Web. Se la query riguarda una terapia, però, la loro importanza generale non basta a stabilire quale sia autorevole sul tema.
Il PageRank originale produce un'unica distribuzione sul grafo. Nel 2002 Taher Haveliwala propose di precomputarne diverse, ciascuna orientata verso un argomento, e combinarle quando arriva la query. Il risultato è il Topic-Sensitive PageRank.
L'idea non consiste nell'aggiungere una keyword al PageRank. Cambia il punto dal quale il navigatore probabilistico riparte: il vettore di teleportation viene concentrato su pagine associate a un tema.
In breve
- Il PageRank globale usa una distribuzione di teleportation generica.
- Topic-Sensitive PageRank calcola offline più vettori, ciascuno biased verso un tema rappresentativo.
- A query time stima i temi della query o del suo contesto e combina i vettori già pronti.
- Il metodo riduce il costo rispetto a un calcolo specifico per ogni query, ma dipende dalla tassonomia e dal classificatore.
- È un paper accademico con esperimenti; non dimostra che Google Search utilizzi oggi quella stessa implementazione.
Il problema dell'autorità fuori tema
Il PageRank globale misura una forma di centralità ricorsiva. La stessa misura deve però servire ricerche completamente diverse. Pagine con molti collegamenti possono ricevere un valore elevato anche quando non hanno un'autorità particolare sull'argomento cercato.
Haveliwala formula il problema in modo diretto: pagine importanti in un dominio possono non esserlo in un altro, indipendentemente dalla presenza delle parole della query nella pagina o nell'anchor text.
Il PageRank query-dependent può orientare transizioni e salti in base alla rilevanza per il termine. È specifico, ma potenzialmente costoso. Topic-Sensitive PageRank cerca un punto intermedio: non un vettore per ogni query, ma una piccola base di vettori per temi.
Il vettore di teleportation diventa tematico
Nel Random Surfer Model il navigatore segue link o si teletrasporta. Se il salto è uniforme, ogni pagina ha la stessa probabilità di essere scelta come destinazione.
Per ottenere un PageRank biased, la probabilità di salto viene concentrata su un insieme di pagine preferite. Nel paper, ciascun insieme rappresenta un tema: ad esempio una categoria di una directory editoriale.
Quando il surfer teletrasporta nel vettore “salute”, riparte più spesso da pagine classificate in quell'area. I link propagano poi questa preferenza nel grafo. Una pagina può quindi ottenere punteggi differenti nei vettori “salute”, “sport” o “informatica”, pur restando identica la struttura degli archi.
Il tema non sostituisce il grafo: definisce il punto di vista dal quale lo percorri.
La pipeline offline e online
Il sistema separa il lavoro in due fasi.
Offline
- scegli un insieme di temi rappresentativi;
- costruisci per ciascuno un vettore di preferenza;
- esegui il calcolo di PageRank biased;
- memorizzi per ogni pagina un punteggio per tema.
A query time
- stimi la distribuzione tematica della query o del contesto;
- recuperi i punteggi tematici precomputati;
- li combini con pesi coerenti con la distribuzione stimata;
- usi il risultato nel ranking insieme agli altri segnali.
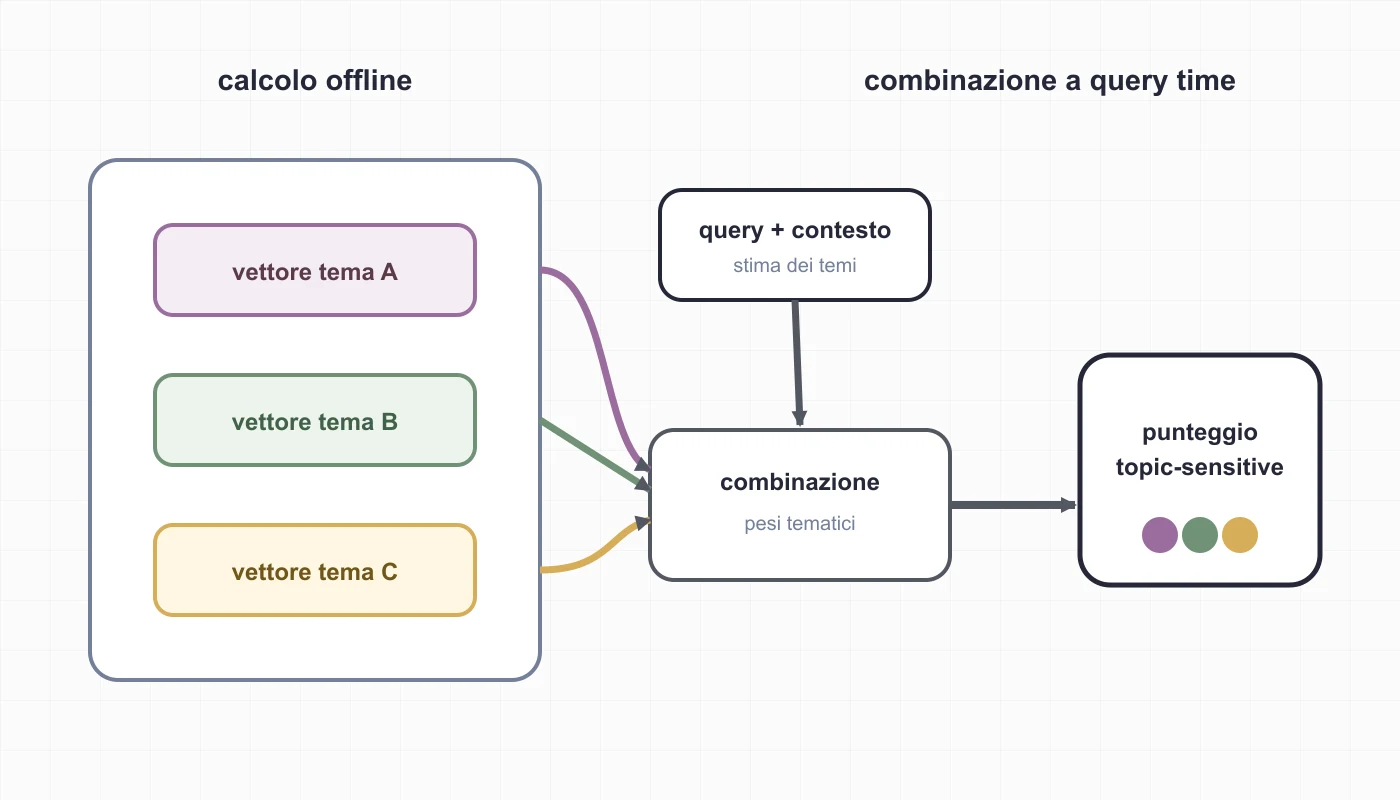
Schema originale della pipeline proposta da Haveliwala. Il numero di temi e la classificazione dipendono dall'implementazione.
Il vantaggio è computazionale: non ricalcoli PageRank sull'intero grafo quando arriva ogni ricerca. Il limite è rappresentazionale: puoi combinare soltanto i punti di vista contenuti nella base tematica.
Sedici temi non sono il mondo
Negli esperimenti del paper, Haveliwala usa le categorie di primo livello dell'Open Directory Project come temi rappresentativi. È una scelta pratica, non una legge del modello.
Una tassonomia molto grossolana riduce il costo ma unisce intenti diversi. Una tassonomia fine aumenta la precisione potenziale ma richiede più vettori, dati e memoria. Inoltre, una query ambigua può distribuire probabilità su più temi.
La query “jaguar” illustra il problema: animale, automobile, squadra sportiva o software possono condividere la stessa stringa. Il contesto in cui la ricerca viene eseguita può aiutare a scegliere la combinazione, ma introduce altri segnali e altre possibilità di errore.
Topic-sensitive non significa personale
Un profilo tematico della query non coincide con una preferenza individuale.
- Tematico: orienta il punteggio verso un argomento condiviso.
- Contestuale: usa la pagina o la situazione da cui parte la ricerca.
- Personalizzato: dipende da interessi o stato di uno specifico utente o insieme di seed.
La stessa matematica del Personalized PageRank può sostenere tutti e tre gli usi cambiando il vettore di preferenza. Per questo i termini vengono talvolta sovrapposti. Editorialmente conviene distinguerli: cambiano dati, scopo e rischi.
Confronto con Hilltop
Il paper cita Hilltop come approccio dalla motivazione simile: cercare autorità specifiche per una query, usando documenti “expert” che collegano pagine rilevanti. La differenza è strutturale.
Topic-Sensitive PageRank propaga una preferenza tematica nell'intero grafo e produce vettori precomputati. Hilltop parte da expert documents individuati per termini o temi e costruisce un authority score legato alla query. Se non trova esperti adeguati, la copertura può ridursi.
“Tematico” non identifica quindi un unico algoritmo. Identifica il problema che più modelli tentano di risolvere.
Che cosa sappiamo davvero
Il paper dimostra che, nel corpus e nel setup sperimentale descritti, la combinazione di vettori tematici può migliorare la qualità rispetto a un singolo PageRank generico secondo le valutazioni raccolte.
Non dimostra:
- che Google abbia adottato il metodo;
- che le categorie ODP siano state usate nel ranking in produzione;
- che una tassonomia editoriale di un sito generi automaticamente autorità tematica;
- che i link fuori tema non trasferiscano alcun valore;
- che l'algoritmo storico descriva sistemi correnti.
Questa distinzione non riduce l'interesse del lavoro. Gli restituisce il significato corretto: una soluzione verificata in uno specifico contesto di ricerca.
Implicazioni per la SEO
Il paper offre un antidoto all'idea di “autorità” come proprietà assoluta. Se devi valutare una sezione, chiediti sempre: autorevole rispetto a quale tema, query e insieme di documenti?
Per l'architettura editoriale, collegare contenuti realmente affini aiuta persone e sistemi a ricostruire relazioni. Ma trasformare la lezione in “crea un silo e otterrai Topic-Sensitive PageRank” sarebbe infondato.
Puoi invece usare tre criteri osservabili:
- copertura: il cluster risponde alle domande necessarie o ripete la stessa query?
- connessioni: i link descrivono relazioni reali fra concetti o servono soltanto a chiudere il circuito?
- accesso: esistono percorsi chiari dal quadro generale agli approfondimenti e ritorno?
Se devi decidere
Se una pagina è forte in termini generali ma debole per una query specialistica, non cercare una sola “metrica di autorità”. Scomponi il problema:
- rilevanza del documento per l'intento;
- qualità e copertura della risposta;
- sostegno ricevuto da contenuti realmente connessi;
- ruolo nel grafo generale e nel sottografo tematico;
- evidenza empirica nelle query e nei percorsi degli utenti.
Questa scomposizione non replica l'algoritmo del paper. Impedisce però a un numero globale di nascondere una debolezza locale.
Fonti
- Topic-Sensitive PageRank — paper, Taher H. Haveliwala, WWW 2002.
- The Intelligent Surfer — paper, Matthew Richardson e Pedro Domingos, NIPS 2001.
- Scaling Personalized Web Search — paper, Glen Jeh e Jennifer Widom, WWW 2003.
- A guide to Google Search ranking systems — documentazione ufficiale Google Search Central, consultata il 4 ottobre 2026.
Approfondimenti
- PageRank globale e query-dependent — il confronto fra misura unica e distribuzione legata alla query.
- Random Surfer Model — teleportation e vettore di preferenza.
- “HITS: hub e authority” — autorità costruita su un sottografo legato alla query.
- “Hilltop e gli expert documents” — un'altra risposta al problema dell'autorità tematica.
Nota sul processo editoriale
Questo articolo e le immagini originali che lo accompagnano sono stati realizzati con il supporto di un agente di intelligenza artificiale progettato su misura per il progetto editoriale di francescoiamurri.com. L'agente ha assistito nella ricerca, nella redazione, nella verifica documentale delle fonti e nella produzione visuale, seguendo un protocollo che distingue paper, brevetti, dichiarazioni ufficiali, osservazioni storiche e inferenze. Francesco Iamurri ha effettuato la revisione editoriale finale, ha approvato il contenuto e ne assume la responsabilità editoriale.