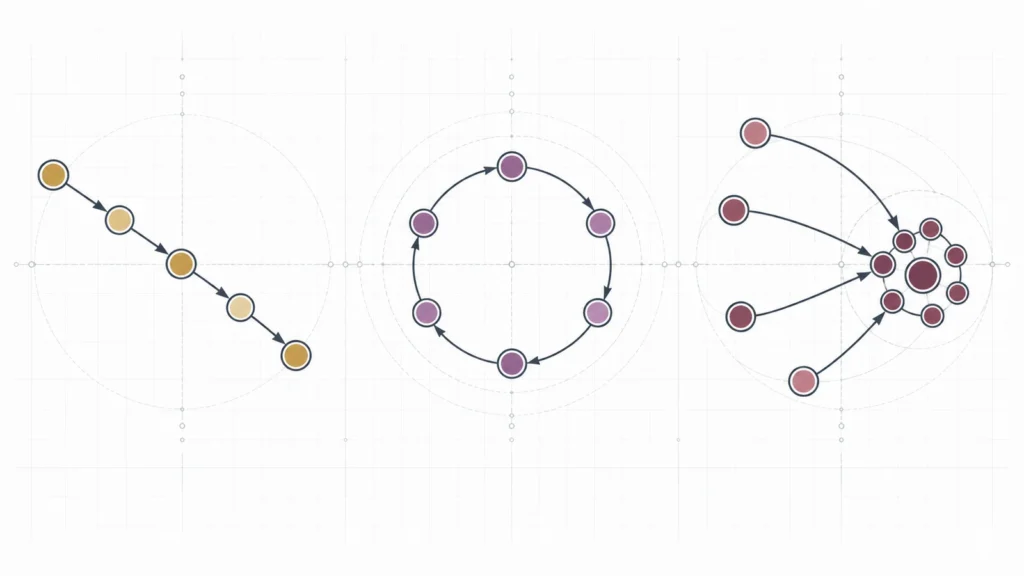
Quando una pagina non ha link uscenti, quando un gruppo collega soltanto se stesso e quando quasi tutto il valore finisce in una zona del grafo, il risultato può sembrare identico: “il PageRank resta bloccato”. In realtà stai osservando problemi diversi.
La distinzione conta perché cambia sia la matematica sia la diagnosi SEO. Un dangling node produce una transizione mancante. Una spider trap crea una regione dalla quale il navigatore non può uscire. Un rank sink descrive una concentrazione persistente di rango, spesso associata a una struttura assorbente o quasi assorbente.
Chiamarli tutti “vicoli ciechi” rende più difficile capire che cosa correggere.
In breve
- Dangling node: nodo senza outlink; la sua colonna nella matrice di transizione non distribuisce probabilità.
- Spider trap: insieme di nodi con link interni ma nessuna uscita; il random walk può entrare e non uscire più.
- Rank sink: zona che assorbe o concentra una quota sproporzionata del rango; descrive l'effetto, non sempre una sola forma strutturale.
- Teleportation e trattamento dei nodi pendenti rendono il processo calcolabile, ma la scelta della correzione influenza il risultato.
- Sul sito reale, pagine orfane e circuiti chiusi sono problemi osservabili; il loro “PageRank Google” non lo è.
Il dangling node: la probabilità non viene ridistribuita
Immagina una pagina PDF senza link, un documento appena scoperto di cui il crawler non ha ancora esplorato le uscite o una pagina HTML che termina davvero il percorso. Se il navigatore casuale arriva lì e il modello prevede soltanto di seguire outlink, non ha una prossima mossa.
In forma matriciale, la colonna relativa al nodo contiene zeri invece di sommare a uno. Applicando ingenuamente le iterazioni, una parte della massa di probabilità scompare. Non è un giudizio di qualità sulla pagina: è una matrice che non rappresenta più una transizione completa.
Il manuale Introduction to Information Retrieval risolve il problema facendo teletrasportare il navigatore quando incontra un nodo senza uscite. Il paper Ranking the Web Frontier discute anche altri trattamenti, come rimuovere temporaneamente i dangling nodes e reinserirli o ridistribuire da essi.
Queste soluzioni non sono necessariamente equivalenti. Rimuovere nodi modifica gli out-degree delle pagine che li collegavano; redistribuire la probabilità conserva altri aspetti del grafo. Il trattamento è parte del modello, non una pulizia neutra.
La spider trap: si entra, non si esce
Una spider trap è un sottografo chiuso. Le pagine al suo interno possono avere numerosi link, ma tutti restano nel gruppo. Una volta entrato, un random walk privo di teleportation continuerà a circolare lì.
Il caso minimo è un nodo con un link soltanto verso se stesso. Un caso più realistico è un insieme di pagine che si collegano reciprocamente senza alcun arco esterno.
Il problema non è una colonna vuota: le transizioni esistono e le probabilità possono sommare correttamente a uno. È la presenza di una classe chiusa che rende la catena riducibile. Se esistono percorsi in entrata ma nessuna uscita, nel lungo periodo il gruppo può assorbire la massa raggiungibile.
Il rank sink: il nome dell'effetto
“Rank sink” viene spesso usato come sinonimo di spider trap, ma è più utile riservarlo all'effetto: una parte del grafo accumula rango senza restituirlo in misura comparabile.
Una spider trap perfetta è un rank sink evidente. Esistono però regioni quasi chiuse con pochissime uscite, nelle quali il navigatore può restare a lungo senza essere intrappolato per sempre. Il damping factor riduce la persistenza, ma la topologia continua a incidere sulla distribuzione.
La distinzione aiuta a non confondere:
- forma: quali archi entrano ed escono dal gruppo;
- processo: quali probabilità governano le transizioni;
- effetto: quanta massa si concentra e per quanto tempo.
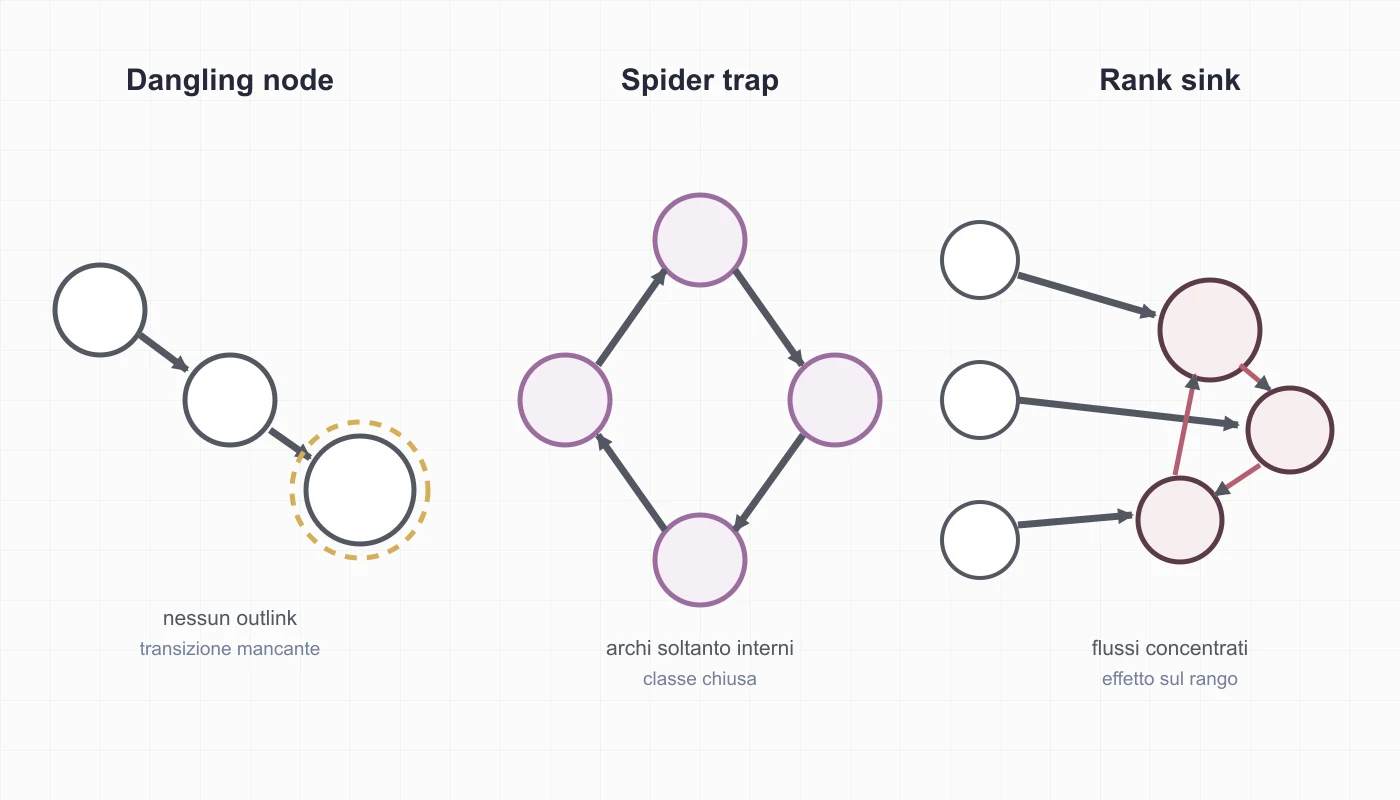
Schema originale e semplificato. Il rank sink rappresenta un effetto di concentrazione, non una singola configurazione universale.
Come interviene la teleportation
Nel Random Surfer Model il navigatore può abbandonare i link e saltare. Da una spider trap, prima o poi il salto offre un'uscita. Da un dangling node, il modello può imporre la teleportation con probabilità uno o sostituire la colonna vuota con una distribuzione definita.
Con probabilità positiva di raggiungere ogni nodo, la catena standard diventa irriducibile; con il self-loop implicito nei salti, evita periodicità problematiche. In condizioni standard ottieni una distribuzione stazionaria unica verso la quale converge la power iteration.
Questa frase tecnica ha una traduzione semplice: indipendentemente dal punto di partenza, ripetendo il processo arrivi alla stessa distribuzione di lungo periodo.
Il Web osservato non è il Web completo
Un aspetto spesso ignorato è che “senza outlink” può significare almeno due cose:
- la pagina non contiene davvero collegamenti uscenti;
- il crawl o il dataset non ha osservato le uscite.
Eiron, McCurley e Tomlin mostrano perché il problema della Web frontier è pervasivo: un crawler conosce moltissimi URL prima di averne scaricato e analizzato i documenti. Il confine del crawl produce nodi apparentemente pendenti anche quando la pagina reale possiede link.
Ne segue una cautela: qualsiasi simulazione di PageRank su un crawl SEO è PageRank di quel grafo osservato, non del grafo di Google. Differenze di copertura, canonicalizzazione, rendering e filtri cambiano nodi e archi.
Implicazioni per l'architettura di un sito
Sul tuo sito puoi misurare problemi concreti senza fingere di replicare Google.
Una pagina orfana non riceve link interni crawlable: è un problema diverso dal dangling node, che riguarda le uscite, ma entrambi segnalano percorsi incompleti. Una sezione che collega quasi soltanto se stessa può essere difficile da scoprire dal resto del sito e può offrire pochi percorsi di ritorno. Una pagina con centinaia di uscite globali distribuisce l'attenzione e la navigazione in modo diverso da una pagina con pochi riferimenti contestuali.
Quello che puoi osservare è:
- raggiungibilità dalla navigazione principale e dai contenuti;
- numero e contesto di inlink e outlink interni;
- componenti debolmente o fortemente connesse;
- pagine terminali e circuiti;
- differenza fra HTML sorgente, DOM renderizzato e grafo estratto dal crawler.
Quello che non puoi osservare è la matrice proprietaria di Google, con tutti i documenti, filtri e pesi.
Se devi decidere
Prima di “aggiungere link per distribuire PageRank”, identifica il problema:
- Se manca una transizione, chiediti se la pagina debba offrire un passo successivo utile.
- Se una sezione è chiusa, verifica se l'isolamento è intenzionale o se impedisce orientamento e scoperta.
- Se il valore sembra concentrato, controlla template, link sitewide e dipendenze da pochi hub.
- Se il risultato proviene da un crawler, misura quanto il grafo è completo e quale versione del documento ha analizzato.
Una correzione architetturale dovrebbe migliorare percorsi, comprensione e manutenibilità anche senza una promessa sul ranking. Se regge soltanto perché immagini una quantità di PageRank non osservabile, la decisione è fragile.
Fonti
- Introduction to Information Retrieval, Chapter 21: Link analysis — manuale accademico, Manning, Raghavan e Schütze, 2008.
- Ranking the Web Frontier — paper, Nadav Eiron, Kevin S. McCurley e John A. Tomlin, WWW 2004.
- PageRank Computation, with Special Attention to Dangling Nodes — paper, Ilse C. F. Ipsen e Teresa M. Selee, 2007.
- The PageRank Citation Ranking: Bringing Order to the Web — technical report, Page, Brin, Motwani e Winograd, 1999.
Approfondimenti
- Il PageRank originale: formula, damping factor e matrice di transizione — la formalizzazione su cui agiscono questi problemi.
- Random Surfer Model — la lettura probabilistica del processo.
Nota sul processo editoriale
Questo articolo e le immagini originali che lo accompagnano sono stati realizzati con il supporto di un agente di intelligenza artificiale progettato su misura per il progetto editoriale di francescoiamurri.com. L'agente ha assistito nella ricerca, nella redazione, nella verifica documentale delle fonti e nella produzione visuale, seguendo un protocollo che distingue paper, brevetti, dichiarazioni ufficiali, osservazioni storiche e inferenze. Francesco Iamurri ha effettuato la revisione editoriale finale, ha approvato il contenuto e ne assume la responsabilità editoriale.