Devi scegliere fra due interventi. Il primo aumenta il numero di link interni verso le pagine strategiche. Il secondo ridisegna la navigazione, elimina passaggi inutili e collega quelle pagine dai punti realmente centrali del sito.
Se guardi soltanto il conteggio dei link, i due interventi possono sembrare equivalenti. Se guardi il sito come un grafo, non lo sono.
Questa differenza è al centro di PageRank. Non basta sapere quante pagine puntano verso una risorsa. Conta anche quali pagine la citano, quale posizione occupano nella rete e fra quanti collegamenti distribuiscono il proprio contributo.
L'idea non nacque dal nulla. Prima del Web, bibliotecari e ricercatori studiavano già le citazioni fra pubblicazioni scientifiche. Ma dire che PageRank “deriva dall'analisi delle citazioni” è solo l'inizio della spiegazione. Per capire che cosa significa davvero bisogna distinguere ciò che PageRank ha ereditato da ciò che ha dovuto reinventare.
In breve
Se vuoi prima la mappa e poi i dettagli, il percorso è questo:
- un indice delle citazioni collega un lavoro ai documenti che lo citano e permette di seguire idee, conferme e critiche;
- rappresentando questi collegamenti come un grafo, ogni documento diventa un nodo e ogni citazione un arco diretto;
- il semplice numero di citazioni ricevute misura la quantità dei collegamenti, ma ignora l'influenza delle fonti;
- i modelli ricorsivi aggiungono un passaggio: una citazione pesa anche in funzione di chi la produce;
- PageRank trasferisce questa logica al Web, normalizzando inoltre il contributo di una pagina per i suoi link in uscita;
- il Web, però, non è una biblioteca scientifica: è aperto, eterogeneo, commerciale e manipolabile.
La conseguenza pratica è semplice: contare i link non equivale a comprendere il grafo. Vale per la storia di Google e vale, con le dovute cautele, quando analizzi un'architettura informativa.
Prima del ranking c'era un problema di scoperta
Nel 1955 Eugene Garfield propose un citation index per la letteratura scientifica. L'obiettivo principale non era costruire una classifica universale dei paper. Era rendere praticabile un tipo di ricerca che gli indici per argomento svolgevano male: partire da un lavoro noto e trovare i documenti successivi che lo avevano citato, discusso o criticato.
Un indice tradizionale cerca di descrivere un documento attraverso categorie e parole. Un indice delle citazioni sfrutta invece una relazione creata dagli autori. Se il paper B cita il paper A, quella relazione permette di muoversi da A verso B anche quando i due lavori usano terminologie diverse o appartengono a discipline lontane.
Garfield definì questo approccio un indice per “associazione di idee”. La citazione diventava una traccia navigabile: non diceva soltanto di che cosa parla un documento, ma anche dentro quale conversazione scientifica si trova.
Questa distinzione è importante. La prima eredità che arriverà al Web non è un punteggio, ma un modo diverso di rappresentare la conoscenza: i documenti acquistano significato anche attraverso le relazioni con altri documenti.
Il punto da ricordare
L'analisi delle citazioni nasce anche come tecnologia di reperimento. Ridurla a un antenato del “numero di backlink” cancella proprio la parte più interessante: la possibilità di scoprire struttura e continuità fra lavori.
Dal catalogo al grafo
Per rendere questa idea computabile serve un modello. Il più utile è il grafo: un insieme di oggetti collegati da relazioni.
Nel nostro caso:
- ogni documento è un nodo;
- ogni citazione è un arco;
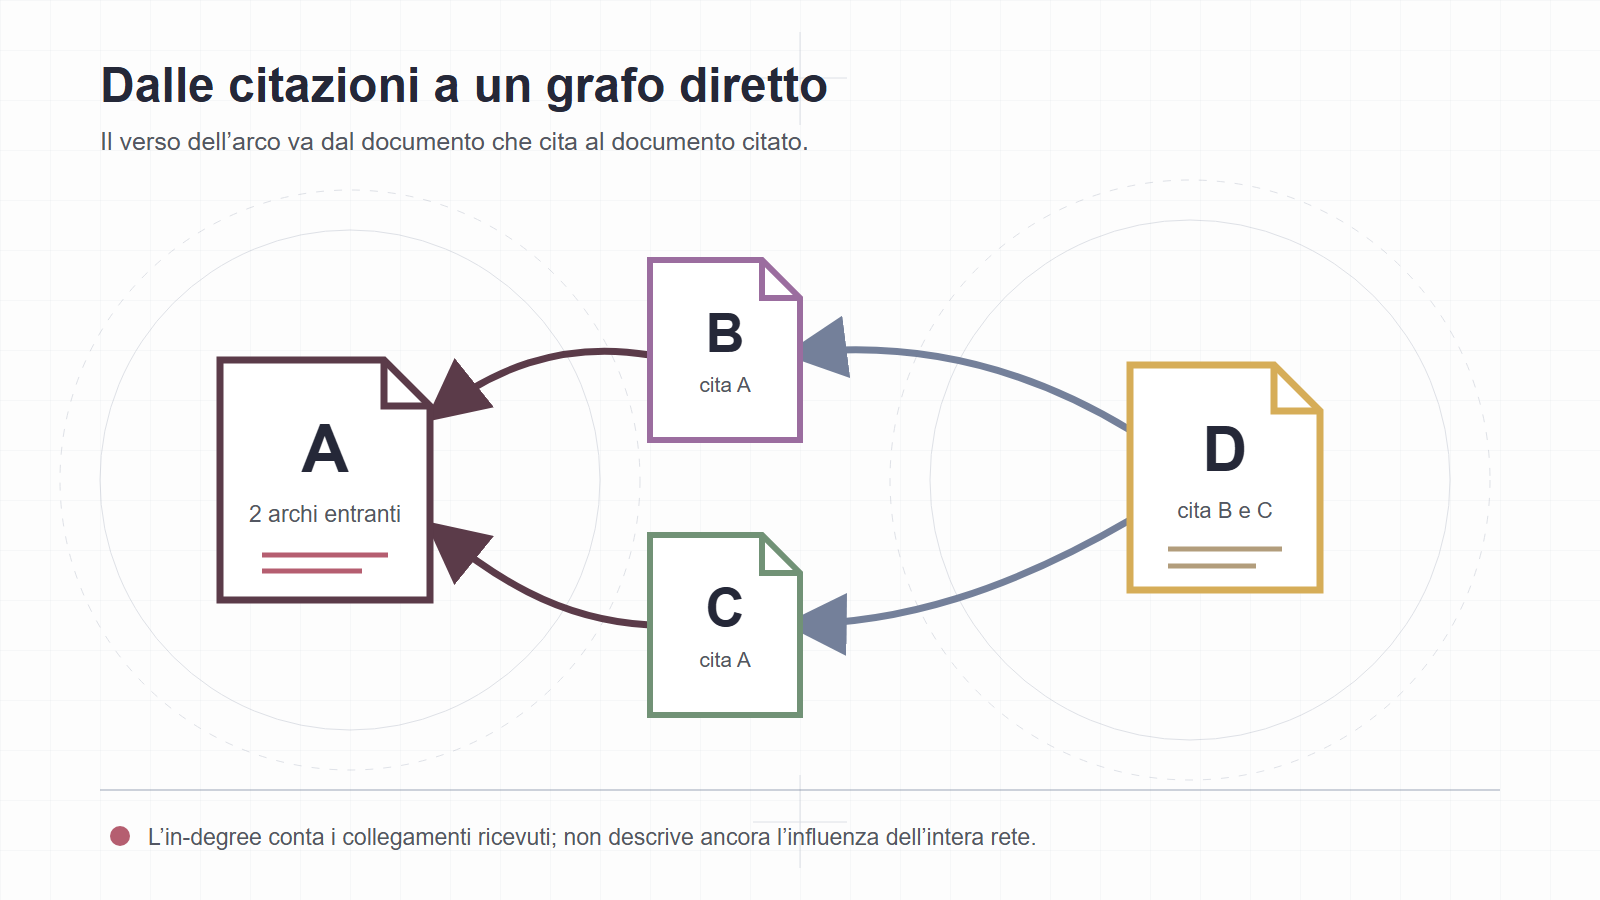
- l'arco ha una direzione, dal documento che cita verso quello citato.
Immagina quattro lavori scientifici:
- B cita A;
- C cita A;
- D cita B e C.
A riceve due citazioni dirette. B e C ne ricevono una ciascuno. D non ne riceve nessuna. Questo conteggio dei collegamenti in entrata si chiama in-degree.
L'in-degree è utile, ma vede soltanto il vicinato immediato di un nodo. Non distingue una citazione proveniente da un lavoro centrale nella disciplina da una citazione proveniente da un documento periferico. Due paper con dieci citazioni ciascuno risultano uguali anche quando sono inseriti in reti molto diverse.
Il limite conduce a una domanda più difficile: possiamo stimare l'influenza di un documento considerando anche l'influenza di chi lo cita?
Quando conta anche chi cita
Nel 1976 Gabriel Pinski e Francis Narin affrontarono un problema simile sulle citazioni fra aggregati di riviste scientifiche. Partendo da una matrice che registrava quali riviste citavano quali altre riviste, formularono un problema agli autovalori per ricavare un peso d'influenza indipendente dalla sola dimensione.
Non serve risolvere la matrice per cogliere l'idea. Il valore è ricorsivo:
- una rivista è influente se viene citata da riviste influenti;
- l'influenza delle riviste che la citano dipende, a sua volta, dalle citazioni che ricevono;
- il calcolo viene ripetuto finché i valori si stabilizzano.
La ricorsività sembra circolare perché, in un certo senso, lo è. Il sistema non assegna prima un'autorità esterna ad alcuni nodi. Cerca una distribuzione di valori coerente con l'intera rete.
È un precedente concettuale importante per le misure di prestigio su grafo. Non permette però di affermare che PageRank sia una semplice implementazione del modello Pinski-Narin o che derivi direttamente da quel singolo paper. Le fonti documentano una parentela di problemi e strumenti matematici; una genealogia più forte richiederebbe prove storiche specifiche.
In pratica
Il conteggio risponde a “quante relazioni riceve questo nodo?”. Un modello ricorsivo prova a rispondere a “quanto sono significative le posizioni della rete dalle quali arrivano?”. Sono domande diverse.
Il salto dal corpus scientifico al Web
Alla fine degli anni Novanta il Web presentava un problema di scala e qualità. Il numero di documenti cresceva rapidamente, mentre l'utente continuava a guardare soltanto i primi risultati. Trovare tutte le pagine contenenti una parola non bastava: occorreva portare in alto quelle più utili.
Nel paper del 1998 The Anatomy of a Large-Scale Hypertextual Web Search Engine, Sergey Brin e Lawrence Page descrissero Google come un prototipo che faceva un uso intenso della struttura ipertestuale. Il loro database conteneva almeno 24 milioni di pagine; le mappe citate nel paper arrivavano a 518 milioni di hyperlink.
Il passaggio decisivo fu trattare il Web come un grafo delle citazioni. Una pagina era un nodo. Un hyperlink verso un'altra pagina diventava un arco diretto. La struttura dei link forniva un'informazione esterna al testo della pagina e poteva contribuire a stimarne l'importanza.
Ma PageRank non si limitava a contare i backlink. Il paper dice esplicitamente che estendeva il conteggio delle citazioni in due modi:
- non attribuiva lo stesso peso ai link provenienti da tutte le pagine;
- normalizzava il contributo in base al numero di link presenti nella pagina sorgente.
Il primo punto introduce l'autorità ricorsiva: un link da una pagina importante contribuisce più di un link da una pagina marginale.
Il secondo evita che una pagina distribuisca interamente la stessa importanza a ciascuna delle cento destinazioni che collega. In forma intuitiva, il suo contributo viene suddiviso fra i link in uscita.
Immagina due pagine, X e Y, con cinque backlink ciascuna. X riceve i link da cinque pagine isolate, ognuna con decine di collegamenti in uscita. Y riceve un link da una pagina molto centrale e quattro da pagine minori. Il conteggio grezzo le considera equivalenti. PageRank può assegnare loro valori diversi perché osserva la provenienza e la distribuzione dei collegamenti.
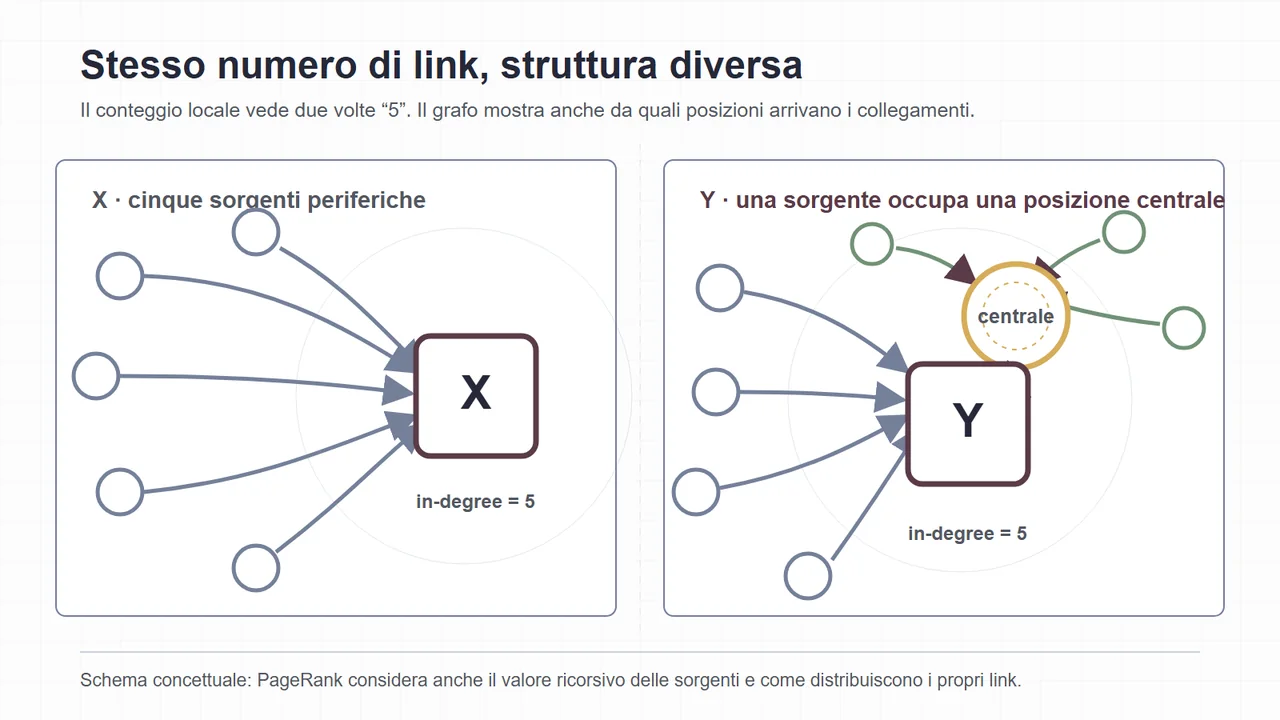
La formula, il damping factor e il modello del Random Surfer meritano un articolo separato. Qui basta la definizione intuitiva del rapporto tecnico: una pagina ha un rango elevato quando è elevata la somma dei ranghi dei suoi backlink. Il valore attraversa il grafo e viene ricalcolato iterativamente.
Un hyperlink non è una citazione scientifica
L'analogia fra hyperlink e citazione è potente, ma non deve diventare un'identità.
Una citazione scientifica viene inserita in un documento con convenzioni relativamente stabili. Può sostenere un'affermazione, attribuire un'idea, discutere un metodo o criticare un risultato. Anche qui le motivazioni non sono uniformi, ma il corpus è soggetto a processi editoriali e norme disciplinari.
Sul Web chiunque può pubblicare, duplicare, generare e collegare contenuti. Un link può essere:
- una raccomandazione editoriale;
- un riferimento necessario;
- un elemento di navigazione;
- una pubblicità;
- un link affiliato;
- una firma di template ripetuta su migliaia di pagine;
- il risultato di uno scambio o di una manipolazione.
Brin e Page erano consapevoli della discontinuità. Il paper descrive il Web come una collezione enorme, eterogenea e priva di controllo, nella quale gli incentivi commerciali rendono la manipolazione un problema concreto.
PageRank non dimostra quindi che ogni link sia un voto sincero. Costruisce una misura della struttura del grafo partendo dall'ipotesi che, su larga scala, i collegamenti contengano informazione utile. La qualità della misura dipende anche da come il sistema tratta relazioni che non meritano lo stesso valore.
Il punto da ricordare
“Link come voto” è una metafora introduttiva, non una descrizione completa. Appena trasformi la metafora in una regola universale, perdi contesto, intenzione e possibilità di abuso.
Che cosa PageRank ha davvero ereditato
La continuità con l'analisi delle citazioni può essere riassunta in quattro elementi:
- Relazioni oltre il testo. Un documento viene compreso anche attraverso i collegamenti creati da altri documenti.
- Direzione. Citare e ricevere una citazione non sono la stessa relazione.
- Influenza non riducibile al conteggio. La fonte di una relazione può modificarne il peso.
- Struttura globale. Il valore di un nodo dipende dalla rete, non soltanto dalle sue caratteristiche interne.
PageRank aggiunse o adattò questi elementi alle condizioni del Web:
- Scala computazionale. Il punteggio doveva essere calcolabile su decine di milioni di pagine e poi su collezioni molto più grandi.
- Normalizzazione degli outlink. Il contributo della pagina sorgente viene distribuito fra le destinazioni.
- Stabilità del calcolo. Il modello include meccanismi che permettono alla distribuzione di convergere anche davanti a particolarità del grafo.
- Uso nel retrieval. Nel prototipo Google, PageRank veniva combinato con segnali testuali per ordinare risultati relativi a una query.
- Ambiente avversariale. La rete non era controllata e poteva essere manipolata per ottenere visibilità.
Non siamo davanti a una copia della bibliometria. Siamo davanti a una traduzione: un problema documentario viene trasferito in un ambiente con oggetti, dimensioni e incentivi diversi.
Il paper storico non è il ranking attuale
La documentazione contemporanea di Google afferma che PageRank continua a far parte dei core ranking systems e che il suo funzionamento si è evoluto molto rispetto alle origini. Le due informazioni vanno conservate insieme.
Possiamo dire che:
- PageRank non è soltanto un reperto storico;
- il modello pubblicato alla fine degli anni Novanta documenta l'origine, non la specifica completa del sistema attuale;
- Google usa vari sistemi di analisi dei link per comprendere le relazioni fra pagine e stimare quali possano essere utili in risposta a una query;
- fonti pubbliche non permettono di ricostruire formula, pesi e interazioni correnti.
Non possiamo prendere la formula originale, osservare un sito nel 2026 e dedurre direttamente come Google ordinerà le sue pagine. Tra il modello storico e il ranking corrente esistono decenni di evoluzione, sistemi contro lo spam, altri segnali e interazioni non pubbliche.
Questo limite non rende inutile la storia. Le impedisce di diventare mitologia operativa.
Che cosa cambia per la SEO
La lezione più resistente non è “ottieni più backlink”. È imparare a ragionare sulle relazioni invece che sui totali.
Architettura interna
Un link interno non modifica soltanto un contatore. Collega due nodi, accorcia o allunga percorsi, inserisce una pagina in una sezione tematica e redistribuisce attenzione attraverso la struttura.
Se una pagina strategica riceve cento link identici dal footer, il numero è alto ma l'informazione strutturale è povera. Se viene collegata dalle pagine che rappresentano davvero snodi decisionali del sito, la relazione è diversa. Da questo non segue una formula certa sul ranking; segue un criterio migliore per progettare navigazione, discovery e gerarchia.
Migrazioni e redesign
Una migrazione può preservare URL e contenuti ma cambiare radicalmente il grafo interno. Menu, breadcrumb, paginazioni, filtri e collegamenti contestuali determinano quali percorsi restano disponibili e quali sezioni diventano periferiche.
Valutare soltanto redirect e status code significa controllare i nodi senza controllare abbastanza le relazioni fra i nodi.
Link acquisition
Il modello storico spiega perché il numero grezzo dei link sia una metrica insufficiente. Non autorizza però la scorciatoia opposta, secondo cui basterebbe inseguire una metrica proprietaria di “autorità” prodotta da uno strumento SEO.
Quelle metriche possono aiutare a confrontare opportunità, ma sono stime costruite su grafi, crawler e formule diversi da quelli di Google. Una decisione solida considera almeno provenienza, pertinenza, posizione editoriale, probabilità di scoperta, rischio e valore indipendente dal ranking.
Audit
Un audit del grafo interno può porre domande più utili del semplice conteggio:
- quali pagine ricevono collegamenti dagli snodi principali?
- quali sezioni sono raggiungibili soltanto attraverso catene profonde?
- dove il contributo si disperde in insiemi di link poco selettivi?
- esistono pagine importanti che il design tratta come periferiche?
- il grafo riflette ancora le priorità del business dopo anni di crescita?
Queste domande non pretendono di replicare PageRank. Usano la stessa intuizione fondamentale: la posizione nella rete contiene informazione che il singolo documento non mostra.
Se devi decidere
Se devi approvare un redesign, una migrazione o un investimento sui link, non fermarti al volume. Chiedi che la proposta renda leggibili cinque aspetti:
- quali relazioni del grafo cambieranno;
- quali pagine o sezioni diventeranno più centrali o più periferiche;
- quale obiettivo viene servito: scoperta, navigazione, comprensione tematica, autorevolezza o conversione;
- quali rischi introduce il cambiamento;
- come verrà verificato l'effetto senza attribuire automaticamente ogni variazione al ranking.
Il grafo non sostituisce contenuto, pertinenza o qualità del prodotto. Mostra qualcosa che quei fattori, osservati da soli, non possono mostrare: il modo in cui le risorse sono messe in relazione.
È questo il passaggio duraturo dalle citazioni accademiche a PageRank. Non l'idea banale che molti link siano sempre meglio, ma l'idea più impegnativa che il valore di una relazione dipenda dalla struttura in cui esiste.
Fonti
- Citation Indexes for Science: A New Dimension in Documentation through Association of Ideas — paper, Eugene Garfield, Science, 15 luglio 1955; consultato il 2 ottobre 2026.
- Citation influence for journal aggregates of scientific publications: Theory, with application to the literature of physics — paper, Gabriel Pinski e Francis Narin, Information Processing & Management, 1976; consultato il 2 ottobre 2026.
- The Anatomy of a Large-Scale Hypertextual Web Search Engine — paper, Sergey Brin e Lawrence Page, 1998; consultato il 2 ottobre 2026.
- The PageRank Citation Ranking: Bringing Order to the Web — rapporto tecnico, Lawrence Page, Sergey Brin, Rajeev Motwani e Terry Winograd, Stanford InfoLab, 1999; consultato il 2 ottobre 2026.
- A guide to Google Search ranking systems — documentazione ufficiale, Google Search Central, aggiornata il 10 dicembre 2025; consultata il 2 ottobre 2026.
Approfondimenti
- Google PageRank — contenuto storico da rileggere alla luce della distinzione fra modello originale e sistemi attuali.
- Link Popularity — confronto con la lettura basata sul conteggio dei link.
- Google: un po' di storia — contesto storico della nascita del motore.
- Il PageRank originale: formula, damping factor e matrice di transizione — approfondimento della formula e del calcolo iterativo.
Nota sul processo editoriale
Questo articolo e le immagini originali che lo accompagnano sono stati realizzati con il supporto di un agente di intelligenza artificiale progettato su misura per il progetto editoriale di francescoiamurri.com. L'agente ha assistito nella ricerca, nella redazione, nella verifica documentale delle fonti e nella produzione visuale, seguendo un protocollo che distingue paper, brevetti, dichiarazioni ufficiali, osservazioni storiche e inferenze. Francesco Iamurri ha effettuato la revisione editoriale finale, ha approvato il contenuto e ne assume la responsabilità editoriale.