Che cosa cambia per aziende, piattaforme e community
Un nuovo configuratore, una pagina condivisibile o uno strumento che genera un risultato possono creare sul dominio aziendale URL che nessuno ha pensato di gestire dal punto di vista SEO. La domanda da fare prima del rilascio è semplice: questa pagina deve essere trovata su Google, aperta da chi riceve un link oppure visibile soltanto a persone autorizzate?
Il 26 ottobre 2026 Google ha aggiornato la propria documentazione sulla prevenzione dello spam generato dagli utenti. Per chi gestisce un sito, la notizia offre l’occasione di controllare una parte spesso trascurata del progetto: le regole con cui le funzionalità pubblicano nuove pagine.
La verifica riguarda il lavoro congiunto di marketing, prodotto, SEO e sviluppo. Una funzione può essere utile al cliente e richiedere comunque impostazioni diverse da una pagina commerciale. Per decidere occorre conoscere il contenuto, il pubblico previsto e il modo in cui l’URL diventa accessibile. Considerare tutte le pagine alla stessa maniera può creare errori in entrambe le direzioni: rendere trovabile ciò che non dovrebbe esserlo oppure escludere una risorsa destinata alla ricerca.
La novità del 26 ottobre: contenuti condivisi e prevenzione degli abusi
Il changelog ufficiale di Search Central registra l’aggiornamento del 26 ottobre alla guida contro lo spam generato dagli utenti. Google richiama esplicitamente strumenti che consentono di pubblicare pagine condivise, contenuti generati e applicazioni web.
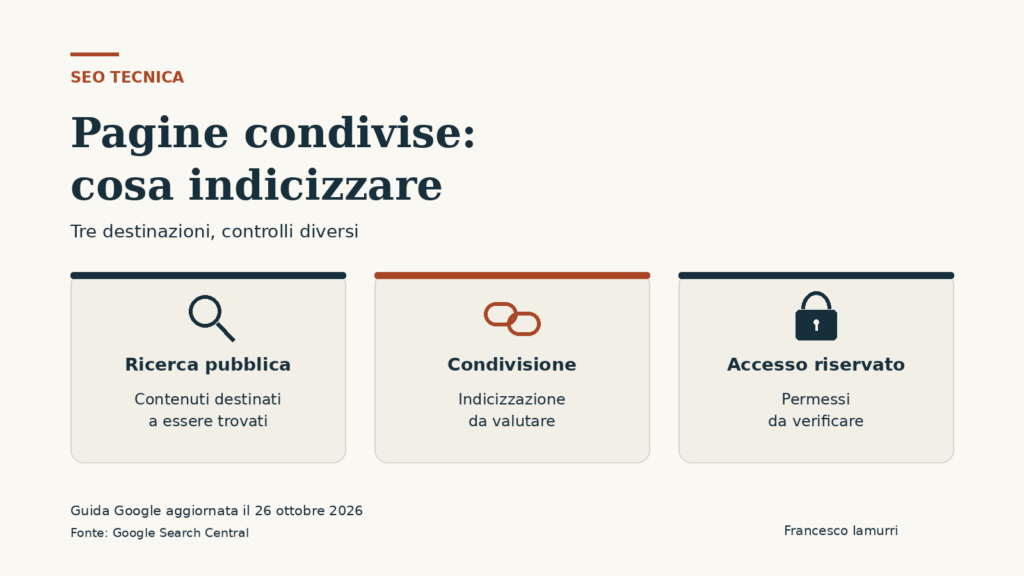
La guida invita a valutare se quelle risorse siano destinate alla ricerca o alla sola condivisione e collaborazione. Rafforza inoltre le indicazioni sul monitoraggio degli abusi. È un aggiornamento documentale, non l’annuncio di un nuovo spam update. Il testo non prescrive l’esclusione indiscriminata di ogni pagina creata dagli utenti.
Prima delle direttive, definire lo scopo della pagina
La proposta operativa è assegnare una destinazione a ogni famiglia di URL prima che il software la produca. La decisione dovrebbe essere esplicita anche nella richiesta di sviluppo: chi può creare la pagina, chi deve leggerla, per quanto tempo serve e chi ne controlla la pubblicazione.
| Situazione | Decisione da prendere | Verifica da documentare |
|---|---|---|
| Contenuto pubblico pensato per rispondere a una ricerca | Valutare l’idoneità alla pubblicazione e alla scoperta tramite motore | Finalità, qualità e responsabilità dell’aggiornamento |
| Risultato pubblico destinato a essere inviato tramite link | Stabilire se debba comparire anche nei risultati di ricerca | Contenuto effettivo e regola di indicizzazione prevista |
| Area contenente informazioni riservate | Definire chi è autorizzato ad accedere | Autenticazione, permessi e comportamento senza sessione |
| Pagina temporanea o risultato ormai inutilizzabile | Decidere conservazione, scadenza o rimozione | Esperienza del destinatario quando il link non è più valido |
Questa matrice è un metodo di lavoro proposto per il progetto, non una classificazione ufficiale di Google. Serve a evitare che l’impostazione predefinita del plugin o del framework sostituisca una decisione aziendale.
Scansione, indicizzazione e accesso rispondono a domande diverse
La scansione riguarda la possibilità del crawler di richiedere una risorsa. L’indicizzazione riguarda la sua presenza nel sistema di ricerca. Il controllo degli accessi stabilisce chi può ottenere il contenuto. Sono piani distinti e vanno verificati separatamente.
Nella guida a robots.txt, Google chiarisce che il file gestisce l’accesso dei crawler, ma non garantisce che un URL scompaia dai risultati: un indirizzo bloccato può essere conosciuto attraverso collegamenti esterni. Per la sicurezza delle informazioni servono controlli di accesso, non direttive affidate al comportamento dei bot.
Per il responsabile aziendale, quindi, “non compare su Google” e “è riservato” non sono criteri di accettazione intercambiabili. Un preventivo destinato a un cliente deve essere valutato prima di tutto per chi può leggerlo. Una pagina pubblica che si vuole escludere dalla ricerca pone un problema differente.
Il punto delicato: noindex e robots.txt non sono equivalenti
La nuova guida antispam affianca noindex e blocco della scansione come possibili impostazioni per contenuti destinati alla condivisione. Va però letta insieme alle istruzioni specifiche: la documentazione di noindex richiede che Google possa accedere alla risorsa per leggerne la direttiva.
Per una pagina HTML pubblica, l’istruzione può trovarsi nell’elemento head:
<meta name="robots" content="noindex">La stessa regola può essere trasmessa come intestazione HTTP, utile anche per risorse non HTML:
X-Robots-Tag: noindexSe una regola Disallow impedisce al crawler di richiedere l’URL, Google potrebbe non vedere il noindex. Non basta quindi aggiungere entrambe le istruzioni e considerare concluso il controllo. L’intervento va scelto in base all’obiettivo e allo stato attuale della risorsa.
Questo ragionamento non giustifica rendere pubblici contenuti riservati affinché il crawler legga un tag. In quel caso va mantenuta la protezione degli accessi e valutata separatamente la presenza dell’URL nella ricerca.
Un esempio aziendale: il risultato di un configuratore
Immaginiamo, come esempio ipotetico, un’azienda che permette di configurare un servizio e salvare il risultato. Il software genera un URL per ogni configurazione e il cliente può inoltrarlo a un collega.
La pagina potrebbe contenere soltanto una combinazione standard di opzioni, oppure includere nominativi, condizioni personalizzate e allegati. Il pulsante “condividi” non permette di dedurre quale sia il livello di protezione richiesto: bisogna leggere il contenuto e definire i destinatari.
Il team può classificare il primo caso come risultato pubblico da valutare per l’esclusione dalla ricerca. Per il secondo deve affrontare autorizzazioni e accesso. Se il marketing vuole invece creare una pagina pubblica su una configurazione particolarmente utile, quella risorsa dovrebbe entrare nel normale processo editoriale, con una finalità e un responsabile riconoscibili.
Il punto da portare nella riunione di progetto è questo: il percorso con cui un utente salva un risultato e quello con cui l’azienda pubblica un contenuto commerciale devono avere requisiti dichiarati. Eventuali vantaggi SEO si valutano dopo aver chiarito questi requisiti.
Una verifica tecnica riproducibile
Per ogni famiglia di URL conviene scegliere esempi rappresentativi e annotare il risultato atteso. Il controllo può seguire questa sequenza:
- Aprire il link senza sessione: verificare quale contenuto arriva a un destinatario non autenticato e se corrisponde a quanto previsto dal progetto.
- Controllare la risposta effettiva: registrare URL finale, codice HTTP, eventuali redirect e intestazioni. Leggere anche il
headdella pagina, se HTML. - Confrontare le regole: esaminare accesso, robots.txt e direttive della risorsa come controlli distinti, segnalando le combinazioni incoerenti con l’obiettivo.
- Provare il processo di creazione: generare un nuovo risultato con dati di test e verificare che riceva le stesse impostazioni degli esempi già esistenti.
- Ripetere dopo la modifica: documentare il comportamento corretto e controllare che pagine commerciali estranee all’intervento mantengano le proprie impostazioni.
Un criterio di accettazione utile è specifico: “i nuovi risultati pubblici di questa funzione ricevono la direttiva prevista”. Una formula come “il sito è protetto dallo spam” è troppo ampia per dimostrare che il problema sia stato risolto.
Come leggere i segnali in Search Console
Il report Indicizzazione delle pagine aiuta a distinguere le esclusioni volute dai problemi. Non è necessario che ogni URL del sito sia indicizzato; per esaminare un indirizzo specifico va usato Controllo URL. Anche gli elenchi di esempi del report non costituiscono un inventario completo.
Per il monitoraggio aziendale si può costruire un prospetto per tipologia di pagina: quante risorse vengono create, quante dovrebbero essere pubbliche e quali scostamenti richiedono un controllo. Le soglie vanno stabilite sulla base dell’uso reale del servizio, senza adottare un numero universale.
Una campagna promozionale può aumentare legittimamente la creazione di configurazioni; un singolo account che pubblica contenuti estranei richiede una verifica diversa. L’allarme serve ad aprire un’indagine, non a dichiarare automaticamente un attacco o una penalizzazione.
Se una pagina indesiderata compare già su Google
Occorre prima capire se la risorsa debba rimanere pubblicamente accessibile. Per contenuti riservati la priorità è correggere l’accesso; per contenuti pubblici esclusi dalla ricerca bisogna verificare che il controllo scelto sia effettivamente applicato e leggibile.
La guida ufficiale alle rimozioni distingue la rimozione temporanea dai risultati dalle misure durature sul sito. La richiesta in Search Console non sostituisce la correzione della risorsa. Inoltre, la lettura di un nuovo noindex richiede una scansione successiva: non va promessa una scomparsa immediata.
Prima di applicare regole a un’intera cartella, il team dovrebbe controllare che non contenga anche pagine di prodotto, servizi o documentazione destinata alla ricerca. La decisione finale va tradotta in una modifica circoscritta, verificata e affidata a un responsabile.
La decisione da prendere prima della prossima funzionalità
Per un’azienda il lavoro utile è assegnare a marketing, SEO e sviluppo una responsabilità condivisa sulla pubblicazione degli URL. Nel documento di rilascio dovrebbero comparire finalità della pagina, destinatari, impostazione prevista e controllo successivo.
Per il professionista SEO, l’occasione è ampliare l’audit alle funzionalità che producono contenuti, oltre alle pagine già visibili nel menu. La verifica parte da come il sito genera e rende disponibili le informazioni: da qui si decide quali risorse debbano entrare nella ricerca e quali debbano seguire un percorso diverso.
Domande frequenti
Google ha annunciato un nuovo spam update il 26 ottobre?
La notizia riguarda l’aggiornamento della guida sulla prevenzione dello spam generato dagli utenti. Quel documento non è un annuncio di rollout algoritmico.
Tutte le pagine condivisibili devono essere escluse dalla ricerca?
No. Va definita la finalità della risorsa: scoperta tramite ricerca, condivisione diretta oppure accesso riservato. La decisione richiede una valutazione del contenuto e dei destinatari.
Posso bloccare una pagina in robots.txt e aggiungere noindex?
Se il blocco impedisce a Google di richiedere la pagina, il crawler non può leggerne il noindex. Le due impostazioni non vanno combinate senza verificarne l’effetto sull’obiettivo scelto.
Una pagina con noindex è riservata?
No. L’esclusione dai risultati non impedisce a una persona di aprire un URL pubblico. I contenuti riservati richiedono controlli di accesso adeguati.