Revisionare manualmente il Web è impossibile. Revisionare pochi punti di partenza e usare il grafo per estendere quella valutazione è invece un problema trattabile. È da qui che parte TrustRank: non da un bollino universale di affidabilità, ma da un metodo semi-automatico per separare pagine reputabili e spam.
In breve
- Un esperto valuta un piccolo insieme di seed candidati.
- Il punteggio viene propagato lungo i link con decadimento e normalizzazione.
- La selezione dei seed determina copertura, precisione e bias.
- Il paper è un esperimento su dati AltaVista del 2004; non documenta un punteggio Google disponibile oggi.
Il problema: l'oracolo umano non scala
Il paper di Gyöngyi, Garcia-Molina e Pedersen assume che un esperto possa riconoscere spam e siti reputabili, ma osserva che il costo rende impossibile farlo su larga scala. La soluzione divide il lavoro: un algoritmo propone candidati ad alto potenziale di copertura, l'oracolo umano valida quelli buoni, poi un PageRank biased propaga il segnale.
L'assunzione centrale è prudente ma imperfetta: le pagine buone raramente linkano pagine spam. “Raramente” non significa “mai”. Un sito compromesso, un link non moderato o un errore editoriale possono trasferire fiducia nella direzione sbagliata.
Come funziona la propagazione
Nel PageRank originale la componente di teleportation può essere uniforme. In TrustRank è concentrata sui seed reputabili. Il punteggio parte quindi da nodi scelti e si distribuisce lungo gli archi, attenuandosi con le iterazioni e con la frammentazione degli outlink.
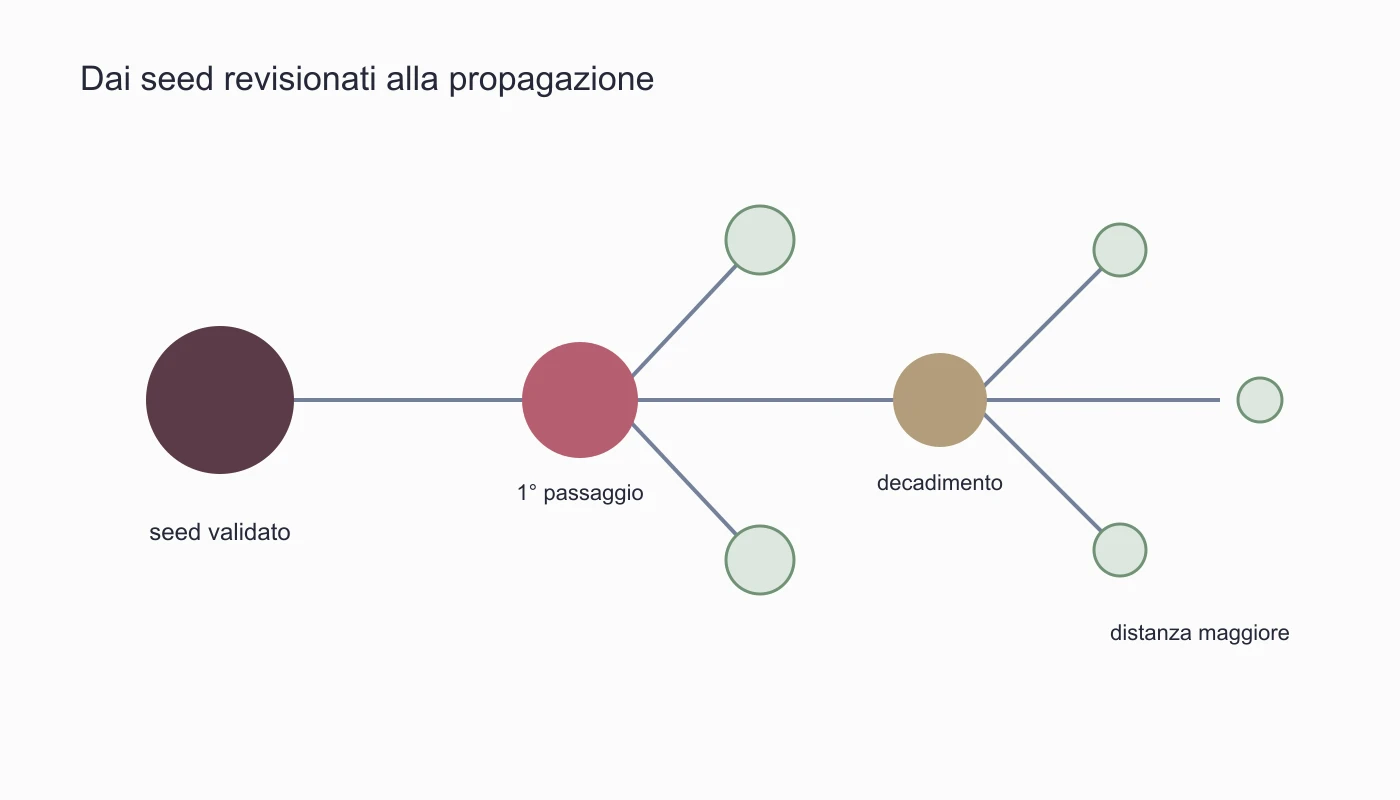
Schema concettuale originale del protocollo TrustRank; non rappresenta un sistema Google.
La distanza conta: un nodo vicino a più seed può ricevere un segnale forte; un nodo lontano, pur legittimo, può riceverne poco. Per questo un valore basso non equivale automaticamente a spam. Il metodo è migliore nel riconoscere una parte delle pagine buone che nel dichiarare cattive tutte le altre.
Come vengono scelti i seed
Gli autori confrontano due euristiche. La prima privilegia pagine ad alto PageRank, utili perché vicine a risultati visibili. La seconda calcola inverse PageRank sul grafo con link invertiti, cercando nodi dai quali sia possibile raggiungere molte pagine.
Nell'esperimento sul Web reale, inverse PageRank produce i candidati; una serie di filtri e revisioni riduce il set fino a 178 seed reputabili. Questo dettaglio impedisce una lettura automatica: l'algoritmo non elimina il giudizio umano, lo concentra dove dovrebbe generare più informazione.
Che cosa sappiamo davvero
Il paper documenta un metodo, un corpus AltaVista e risultati sperimentali secondo cui meno di 200 seed ben scelti permettono di filtrare spam da una porzione significativa del Web. Gli stessi autori dichiarano limiti nella valutazione: uno degli autori svolse il ruolo di oracolo e il protocollo richiese settimane.
Non sappiamo da questa fonte se Google abbia usato TrustRank, con quali modifiche o se esista oggi un sistema omonimo. “Trust” è anche un termine troppo generico per dedurre un meccanismo specifico da una dichiarazione sulla qualità.
Implicazioni per la SEO
La lezione principale è che l'autorevolezza non si legge bene in isolamento. Contano i percorsi che collegano una pagina a fonti revisionate e la qualità del protocollo con cui quelle fonti sono state scelte. Ma non puoi trasformare questa lezione in una lista di “trusted domains” o in un numero di salti valido per ogni motore.
Per un audit, usa la distanza da fonti riconoscibili come indizio: aiuta a formulare domande sulla rete di citazioni, non a emettere una sentenza automatica.
Se devi decidere
Quando confronti segnali di link, verifica tre elementi: provenienza dei punti di partenza, indipendenza dei percorsi e possibilità di contaminazione. Se non puoi spiegare come sono stati scelti i seed, non presentare il punteggio derivato come misura oggettiva della fiducia.
Fonti
- Combating Web Spam with TrustRank — paper, Zoltán Gyöngyi, Hector Garcia-Molina e Jan Pedersen, VLDB 2004.
Approfondimenti
- Il PageRank originale — base matematica della propagazione biased.
- “Spam Mass: stimare quanto ranking arriva dal link spam” — uso complementare di una stima della massa sospetta.
- “Seed set: perché la propagazione dipende dai punti di partenza” — selezione, copertura e bias.
Nota sul processo editoriale
Questo articolo e le immagini originali che lo accompagnano sono stati realizzati con il supporto di un agente di intelligenza artificiale progettato su misura per il progetto editoriale di francescoiamurri.com. L'agente ha assistito nella ricerca, nella redazione, nella verifica documentale delle fonti e nella produzione visuale, seguendo un protocollo che distingue paper, brevetti, dichiarazioni ufficiali, osservazioni storiche e inferenze. Prima della pubblicazione, Francesco Iamurri effettua la revisione editoriale finale, approva il contenuto e ne assume la responsabilità editoriale.